
ソフトウェア開発者として、私たちは毎日多くのコードを書きます。コードの一つひとつにはそれぞれの物語があります。それは次のようなものかもしれません。
- ウェブリソース(フォーラム、チュートリアル、ブログ記事など)に触発されたもの。
- GitHub、SourceForge、その他のオープンソースプロジェクトに触発されたもの。
- プロジェクト自体からコピー&ペーストしたもの。
- ゼロから開発したもの。
コードの各部分について、開発者は解決すべき問題を分析します。彼らのバックグラウンドやチームの意見は、選択やコードの書き方に大きく影響する可能性があります。
コードを書いてコミットした後、それがプロジェクトのメンテナーや開発者が遅かれ早かれ対処しなければならない技術的負債をもたらす可能性があることを心に留めておきましょう。この負債を最小限に抑え、プロジェクトに携わる全員の作業を楽にするために、最初からコードをクリーンに保ついくつかの良い習慣を採用するのが最善です。
1. 命名
変数や関数がa、b、xと名付けられているために、その目的を理解するだけで多くの時間を費やすことがあります。最初から明確で意味のある名前が付けられていれば、その意味は明白だったでしょう。
一貫した命名規則に従う明確で意味のある名前は、次のことに役立ちます。
- ソースコードを読み理解するのに必要な労力を削減する。
- コードレビューが、構文や命名規則に関する議論ではなく、より重要な問題に集中できるようにする。
- コード品質ツールが、構文やスタイルの好みではなく、重要な問題にレポートを集中できるようにする。
2. 可視性
可視性を狭めることは、カプセル化を促進するための良い慣行です。スコープを最小限に抑えることで、コードのユーザーは、クラスの外部からアクセスすることを意図したメンバーがどれかを正確に理解できます。
すべてのクラスメソッドをpublicにすると、ユーザーを混乱させ、クラスの契約を曖昧にする可能性があります。その場合、どのメソッドを使用することが意図されているかを判断するためにドキュメントが必要になります。
3. パラメータ
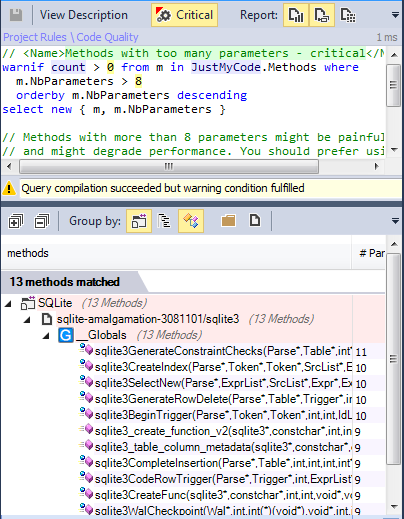
5つを超えるパラメータを取る関数は、2つの問題のいずれかを示しています。
- 関数がやりすぎている。それぞれがより小さなパラメータセットを持つ、複数の小さな関数に分割すべきです。
- その中に別のオブジェクトが隠れている。これらのパラメータを含む別のオブジェクトやデータ構造を作成する必要があるかもしれません。
これを行うと、いくつかの利点があります。
- コードが読みやすくなります。
- 単体テストが容易になります。
4. サイズ
長すぎるメソッドは、保守も理解も容易ではありません。 Linuxコーディングスタイルのウェブページから、関数の長さに関するアドバイスを紹介します。
Functions should be short and sweet, and do just one thing.  They should
fit on one or two screenfuls of text (the ISO/ANSI screen size is 80x24,
as we all know), and do one thing and do that well.

The maximum length of a function is inversely proportional to the
complexity and indentation level of that function.  So, if you have a
conceptually simple function that is just one long (but simple)
case-statement, where you have to do lots of small things for a lot of
different cases, it's OK to have a longer function.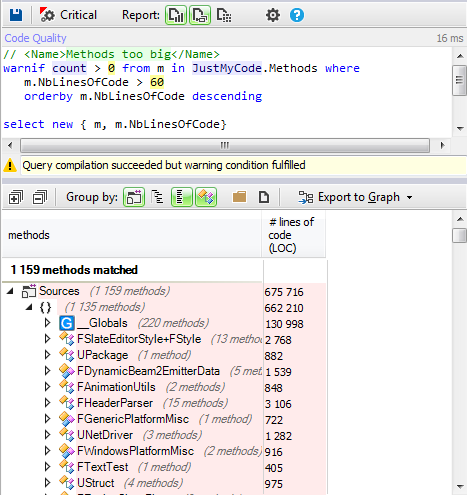
から、関数の長さに関するアドバイスを紹介します。
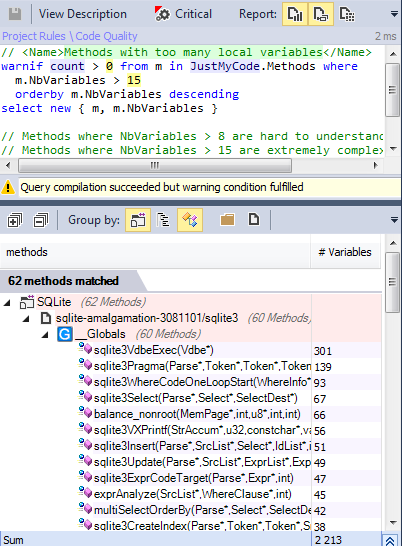
NbVariablesが8を超えるメソッドは理解と保守が困難です。NbVariablesが15を超えるメソッドは非常に複雑であり、より小さなメソッドに分割すべきです(ツールによって自動生成された場合を除く)。
6. 複雑な関数の定義を避ける
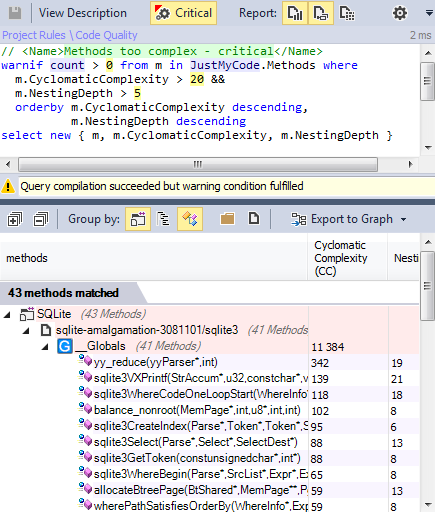
複雑な関数を検出するために多くのメトリクスを使用できます。NBLinesOfCode、パラメータの数、ローカル変数の数が最も基本的なものです。
他の有用なメトリクスも、複雑な関数を特定するのに役立ちます。
- 循環的複雑度は、手続き内で取り得る決定の数に等しい結果を返す、人気のある手続き型ソフトウェアメトリクスです。
- ネスト深度は、メソッド本体内のネストされたスコープの最大深度を表すメソッドレベルのメトリクスです。
- 最大ネストループは、関数内のループネストの最大レベルに等しい値です。
これらのメトリクスの許容される最大値は、普遍的なしきい値がないため、チームの好みに大きく依存します。
リファクタリングが必要かもしれない関数を探してみましょう。
7. フォーマット
プログラミングスタイルとインデントは、ソースコードを整理し文書化するために選択する方法として定義できます。コードのインデントはプログラミングスタイルの一部であり、主に可読性と美しさに関するものです。適切なスタイルガイドとインデントに従えば、プログラムは詩のようになり、読み手はその意味を快適に理解しながら読み進めることができます。ご存知のように、適切なコードのインデントはコードを次のようにします。
- 読みやすい
- 理解しやすい
- 修正しやすい
- 保守しやすい
- 拡張しやすい
コードのインデントとスタイルの目的は、プログラムを読みやすく理解しやすくすることです。これにより、コードを再訪したり再利用したりするときに多くの時間を節約できます。スタイルガイドは、開発者がコーディング時に従うべきロードマップを提供し、開発者グループ内で生成されるすべてのコードが一貫した性質を持ち、どの開発者でも再利用できるようにします。
8. コメント
コードにまったくコメントがない場合もあれば、過剰にコメントされている場合もあります。おそらくこの言葉を読んだことがあるでしょう。 良いコードは自己文書化されている。
確かに、コードをクリーンに保ち、コメントを避けてコード自体に語らせるのは良い慣行です。しかし、現実の世界ではそれが常に簡単なわけではありません。場合によっては、コードが何をするかを明確にする必要があります。
9. 結合度
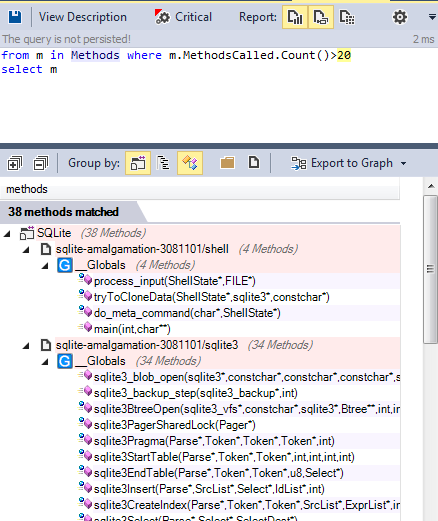
低結合は望ましいものです。アプリケーションのある領域の変更が、アプリケーションの他の場所で必要とする変更を少なくするからです。長期的には、これによりアプリケーションの修正や新機能の追加に伴う時間、労力、コストを削減できます。
多くの他の関数に依存する関数は、理解と保守が困難になる可能性があります。関数のエファレント結合を最小限に抑えることが推奨されます。
10. 凝集度
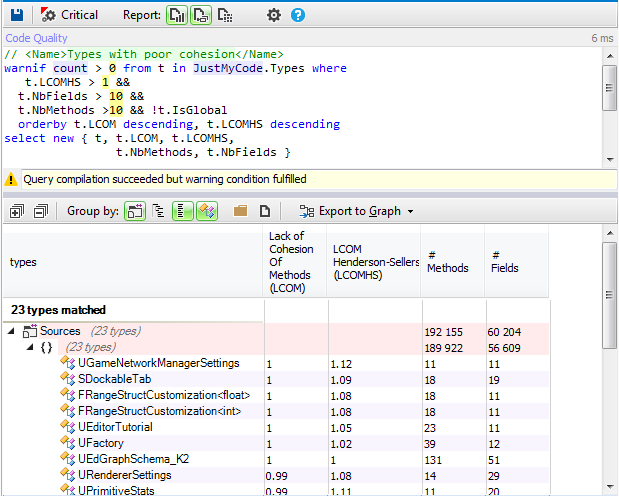
単一責任の原則は、クラスは変更する理由を1つだけ持つべきであると述べています。そのようなクラスは凝集性が高いと言われます。高いLCOM値は一般に、凝集性の低いクラスを示します。いくつかのLCOMメトリクスがあります。LCOMは[0-1]の範囲の値を取ります。LCOM HS(HSはHenderson-Sellersの略)は[0-2]の範囲の値を取ります。1を超えるLCOM HS値は警戒すべきと考えるべきです。LCOMメトリクスの計算方法は次のとおりです。
LCOM = 1 – (sum(MF)/M*F) LCOM HS = (M – sum(MF)/F)(M-1)
ここで:
- Mはクラスのメソッド数です(staticメソッドとインスタンスメソッドの両方がカウントされます。コンストラクタ、プロパティのゲッター/セッター、イベントのadd/removeメソッドも含まれます)。
- Fはクラスのインスタンスフィールドの数です。
- MFは、特定のインスタンスフィールドにアクセスするクラスのメソッドの数です。
- sum(MF)は、クラスのすべてのインスタンスフィールドにわたるMFの合計です。
これらの式の背後にある基本的な考え方は、次のように述べることができます。クラスのすべてのメソッドがすべてのインスタンスフィールドを使用する場合、そのクラスは完全に凝集しており、sum(MF)=M*Fとなり、LCOM = 0、LCOMHS = 0となります。
1を超えるLCOMHS値は警戒すべきと考えるべきです。
結論
これらは、最初からコードをクリーンに保つのに役立ついくつかの基本的な習慣です。大規模なリファクタリングを待たずに、最初からクリーンに保つよう心がけましょう。