GCC(GNU 编译器集合)和 Clang 是软件开发领域最著名的两款 C++ 编译器。它们各自有着独特的设计哲学和架构,以满足不同的需求和偏好。本文探讨 GCC 与 Clang 之间的根本性设计差异,并重点说明这些差异如何影响它们的功能、性能和易用性。
架构设计差异
- Clang:Clang 的设计高度模块化。它由一系列定义良好的库(前端、中端和后端)组成,这些库可以独立使用,也可以组合使用。这种模块化使 Clang 易于扩展和维护。LibClang 还为 Clang 库提供了稳定的 C 接口,便于开发工具和 IDE 集成。
- GCC:从历史上看,GCC 被设计为组件紧耦合的单体编译器。虽然随着时间推移它变得更加模块化,但其模块化程度仍不及 Clang。GCC 支持插件,但与 Clang 更灵活的设计相比,其架构使其更难扩展。
让我们更深入地了解 Clang 的设计,看看为什么它的架构使添加新特性和插件更加容易。
Clang 的设计
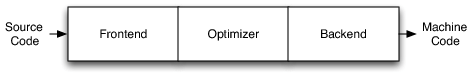
与许多其他编译器设计一样,Clang 编译器分为三个阶段:
- 前端解析源代码,检查错误,并构建特定语言的抽象语法树(AST)来表示输入代码。
- 优化器对前端生成的 AST 执行优化。
- 后端为目标架构生成最终的机器码。
Clang 与其他编译器的不同之处在哪里?
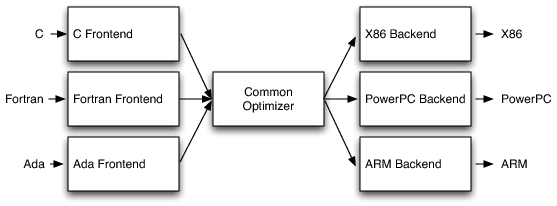
其设计中最重要的区别在于 Clang 基于 LLVM。LLVM 背后的理念是使用 LLVM 中间表示(IR);它类似于 Java 的字节码。
LLVM IR 旨在承载编译器优化器部分中的中层分析和变换。它在设计时考虑了许多具体目标,包括支持轻量级运行时优化、跨函数/过程间优化、全程序分析以及激进的重组变换等。不过,它最重要的一点是:它本身被定义为一门具有明确语义的一等语言。
通过这种设计,编译器的大部分可以被复用来创建其他编译器。例如,您可以只更换前端来处理其他语言。
一、前端
Clang 采用模块化设计,每个编译阶段由特定的模块完成。以下是参与前端阶段的一些项目:
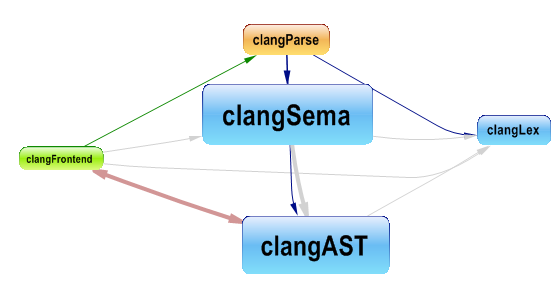
与任何前端解析器一样,我们需要词法分析器和语义分析。可以通过传入 -cc1 参数来执行 Clang 前端。它提供了多种功能,例如 AST 生成:
clang -cc1 -ast-dump test.c
该命令由 cc1_main 函数处理。以下是执行过程中一些值得关注的方法序列:
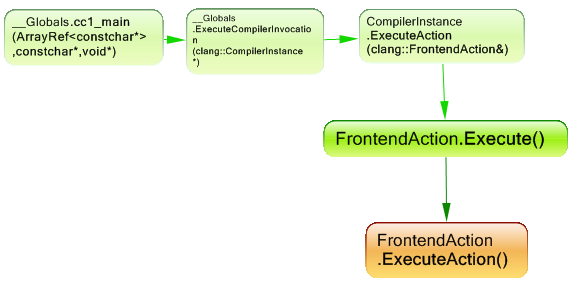
方法ExecuteAction有一个类型为FrontEndAction的参数;其目的是指定要执行哪个前端动作。FrontEndAction 是一个抽象类,我们需要继承它来实现具体的前端动作。
让我们使用CQLinq来找出 Clang 实现的所有前端动作——为此,我们可以搜索所有直接或间接继承自它的类。
from t in Types
let depth0 = t.DepthOfDeriveFrom(“clang.FrontendAction”)
where depth0  >= 0 orderby depth0
select new { t, depth0 }
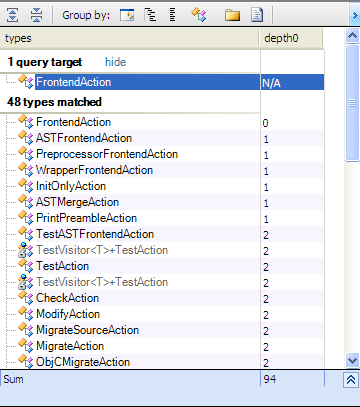
有许多可用的前端动作。例如,ASTDumpAction 在不生成最终可执行文件的情况下输出 AST。几乎所有前端动作都继承自 ASTFrontEndAction,这意味着它们都基于生成的 AST 工作。
这种设计的有趣之处在于,我们可以轻松插入自定义的 FrontEndAction;只需实现一个新的即可。
我们如何对 AST 执行一些处理?
每个 ASTFrontEndAction 会创建一个或多个 ASTConsumer 实例。ASTConsumer 类是一个抽象类,我们必须根据自己的特定需求实现自己的 AST 消费者。
FrontEndAction 将按照下面的依赖关系图所示调用 AST 消费者。
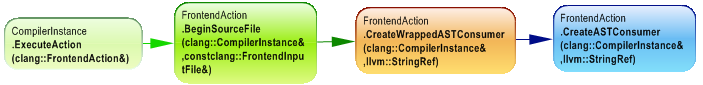
让我们使用CQLinq中的阐述:
from t in Types
let depth0 = t.DepthOfDeriveFrom(“clang.ASTConsumer”)
where depth0  == 1
select new { t, depth0 }
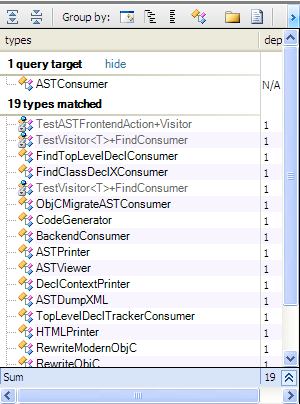
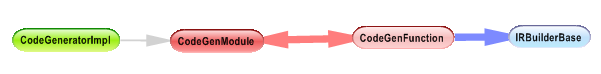
CodeGenerator 就是 AST 消费者的一个例子。如前所述,LLVM 的优势之一是使用 IR,而生成 IR 需要解析 AST。CodeGenerator 是继承自 ASTConsumer、负责生成 IR 的类,有趣的是,这部分处理被隔离到了另一个名为 ClangCodeGen 的项目中。
以下是参与 LLVM IR 生成的一些类:
二、优化器
要解释这个阶段,我说得再好也不如 LLVM 之父 Chris Lattner 在这篇文章中的阐述:
"为了直观地说明优化是如何工作的,最好通过一些例子来讲解。编译器优化有许多不同的种类,因此很难为解决任意问题提供一个通用的配方。尽管如此,大多数优化都遵循一个简单的三段式结构:
- 寻找要被变换的模式。
- 验证该变换对匹配的实例是否安全/正确。
- 执行变换,更新代码。
优化器读入 LLVM IR,对其进行一番处理,然后输出有望执行得更快的 LLVM IR。在 LLVM 中(与许多其他编译器一样),优化器被组织为由不同优化遍(pass)组成的流水线,每一遍都在输入上运行并有机会做些事情。常见的优化遍包括内联器(将函数体替换到调用点)、表达式重结合、循环不变量代码外提等。根据优化级别的不同,运行的优化遍也不同:例如在 -O0(无优化)时,Clang 编译器不运行任何优化遍;在 -O3 时,其优化器会运行多达 67 个优化遍(截至 LLVM 2.8)。
让我们通过搜索继承自"pass"类的类来探索 LLVMCore 的优化遍。
from t in Types
let depth0 = t.DepthOfDeriveFrom(“llvm.Pass”)
where t.ParentProject.Name==”LLVMCore” && depth0  >= 0 orderby depth0
select new { t, depth0 }
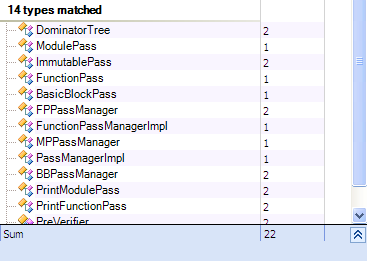
当然,其他 LLVM 模块中还存在许多其他优化遍。
三、后端
与其他阶段一样,后端负责为特定目标生成输出。在 Clang 中,这一阶段高度模块化。以 LLVMX86Target 为例,它为 x86 目标生成代码。
下面是一张展示参与生成 x86 目标二进制文件的所有模块的图。
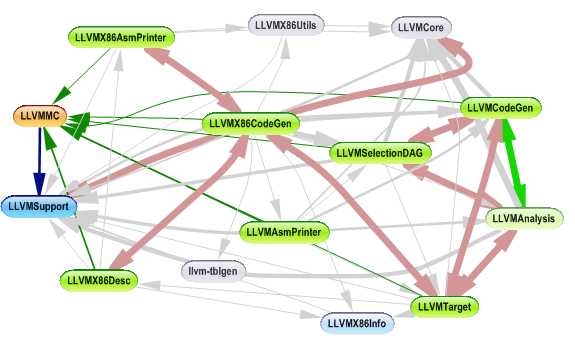
许多模块参与了这一阶段,每个模块都有特定的职责。这促进了内聚性、干净的 API 和关注点分离,使系统更易于开发者理解,因为他们可以专注于大图景中的小块部分。
结论
LLVM/Clang 组合不仅仅是一个 C/C++ 编译器;它还是构建工具的基础设施,并且很容易扩展其行为。LLVM/Clang 源代码中开箱即用地包含了许多工具,网上还能找到更多。
如果您需要一个 C/C++ 解析器来构建工具,Clang 是非常好的选择。