
每个项目都有自己的风格指南:一套关于如何为该项目编写代码的约定。有些管理者选择基础的编码规则,有些则偏好非常高级的规则。而在许多项目中,根本没有任何编码规则——每个开发者各用各的风格。
当所有源代码都保持一致的风格时,理解一个大型代码库会容易得多。
许多资源都讨论过应该采用哪些最佳编码规则。我们可以通过以下方式学习良好的编码实践:
- 阅读书籍或杂志。
- 网站。
- 向同事请教。
- 参加培训课程。
另一种更有趣的方法是研究一个知名、成熟的开源项目,看看它的开发者是如何编写代码的。在 C 语言的世界里,Linux 内核就是一个很好的选择。
对于初级甚至中级的 C 开发者来说,Linux 内核可能不太容易深入。不过,我们的目标并不一定是为其源代码做贡献,而是去探索它是如何实现的。
让我们以 Linux 源代码中的一个函数实现为例。
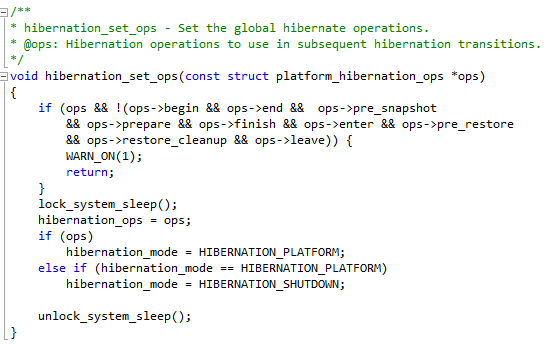
代码看起来非常整洁;事实上,这个函数:
- 只有寥寥几行代码。
- 函数签名定义良好。
- 注释完善。
- 缩进良好。
- 变量名非常清晰。
同一个函数,另一位开发者可能会这样实现:
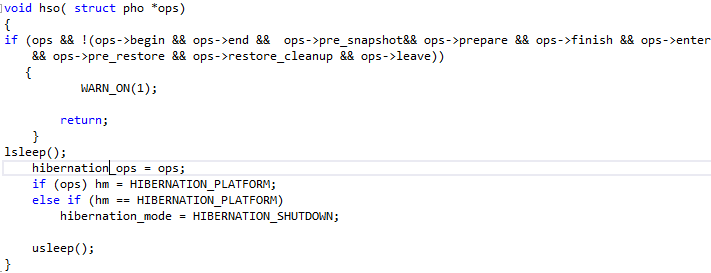
编码风格对源代码的可读性有重大影响。投入几个小时进行开发者培训,并定期开展代码评审,可以让代码更易于维护和演进。
让我们使用CppDepend深入 Linux 内核源代码,看看它的开发者采用了哪些基本编码规则。
模块化
模块化是一种软件设计技术,它提高软件由独立部分组合而成的程度,使模块化代码更易于管理和维护。
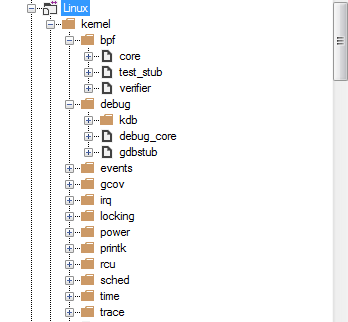
对于 C 这样的过程式语言,由于不存在命名空间、组件或类等逻辑结构,我们可以通过目录和文件来实现模块化。
以下是几种可能的场景:
- 把所有源文件放在一个目录中。
- 把与某个模块或子模块相关的文件隔离到特定的目录中。
在 Linux 内核的案例中,目录和子目录被用来模块化内核源代码。
封装
封装是指隐藏实现内部的函数和数据。在 C 语言中,封装通过 static 关键字实现。这些实体被称为文件作用域的函数和变量。
让我们执行下面的 CQLinq 查询,搜索所有静态函数。

我们可以使用度量视图来直观地了解涉及的函数数量。在度量视图中,代码库通过矩形树图(Treemap)表示。矩形树图是一种使用嵌套矩形展示树状结构数据的方法。CppDepend 矩形树图中使用的树结构是常见的代码层级:
- 项目包含目录。
- 目录包含文件。
- 文件包含结构体、函数和变量。
矩形树图视图为表示 CQLinq 查询结果提供了一种实用的方式,让我们能够直观地看到受影响的代码元素。
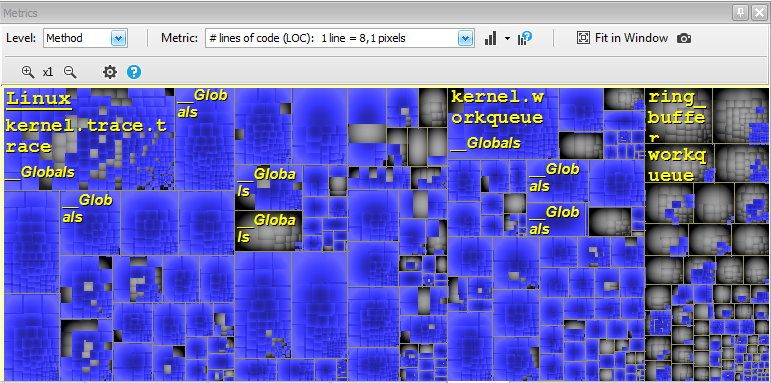
我们可以看到,许多函数被声明为 static。
现在让我们搜索静态字段:
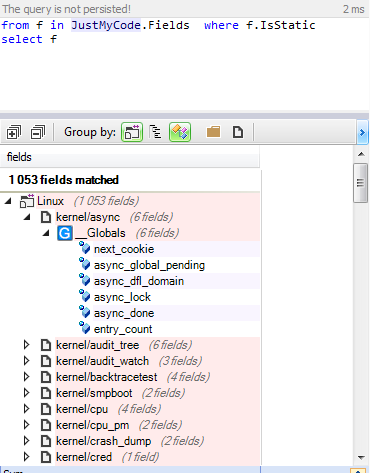
同样的观察也适用于变量:许多变量被声明为 static。
在 Linux 内核源代码中,只要函数和变量必须在文件作用域内保持私有,就会使用封装。
使用结构体存储数据模型
在 C 编程中,函数使用变量来完成处理;这些变量可以是:
- 静态变量。
- 全局变量。
- 局部变量
- 结构体中的变量。
每个项目都有自己的数据模型,可能被许多源文件使用。使用全局变量是一种解决方案,但不是好的方案;将数据分组到结构体中更为可取。
让我们搜索基本类型的全局变量:
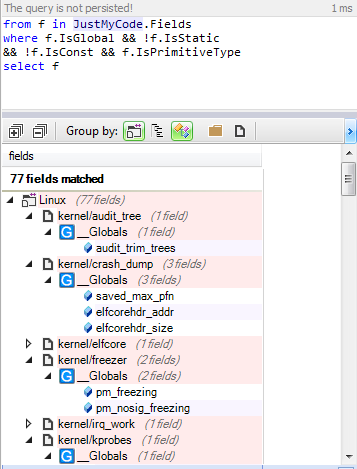
只涉及少量变量,其中一些或许可以分组到结构体中,比如(elfcorehdr_addr 和 elfcorehdr_size)或(pm_freezing 和 pm_nosig_freezing)。
让函数短小精悍
以下是Linux 编码风格网页上关于函数长度的一些建议:
Functions should be short and sweet, and do just one thing.  They should
fit on one or two screenfuls of text (the ISO/ANSI screen size is 80x24,
as we all know), and do one thing and do that well.

The maximum length of a function is inversely proportional to the
complexity and indentation level of that function.  So, if you have a
conceptually simple function that is just one long (but simple)
case-statement, where you have to do lots of small things for a lot of
different cases, it's OK to have a longer function.
让我们搜索代码行数超过 30 的函数。
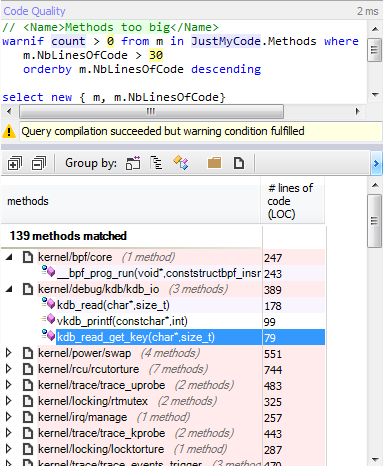
只有少数函数超过 30 行代码。
函数参数数量
参数个数 NbParameters > 8 的函数可能调用起来很痛苦,还可能降低性能。一种替代方案是提供一个专门用于传递参数的结构体。
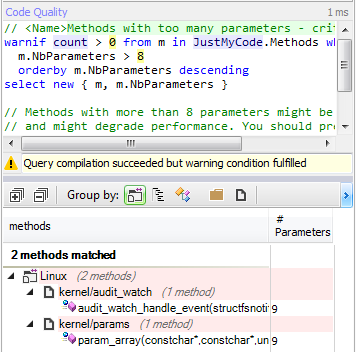
只有两个函数的参数超过 8 个。
局部变量数量
局部变量数 NbVariables 大于 8 的函数难以理解和维护。NbVariables 大于 15 的函数则极其复杂,应该拆分为更小的函数(除非它们是由工具自动生成的)。
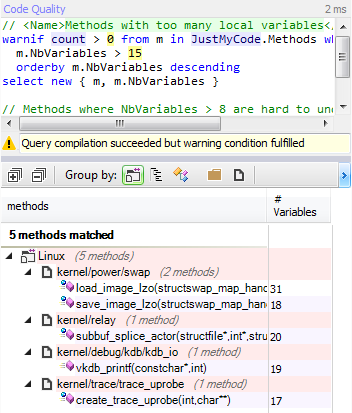
只有 5 个函数的局部变量超过 15 个。
避免定义复杂的函数
有许多度量可以检测复杂函数;代码行数(NBLinesOfCode)、参数个数和局部变量个数是其中最基本的。
还有其他一些检测复杂函数的有趣度量:
- 圈复杂度是一个流行的过程式软件度量,用于衡量一个过程中的决策路径数量。
- 嵌套深度是针对函数定义的度量,表示函数体内嵌套作用域的最大深度。
- 最大嵌套循环(Max Nested Loops)等于函数中循环嵌套的最大层数。
这些度量可接受的最大值取决于团队的选择;没有通用标准。
让我们搜索可能成为重构候选的函数:
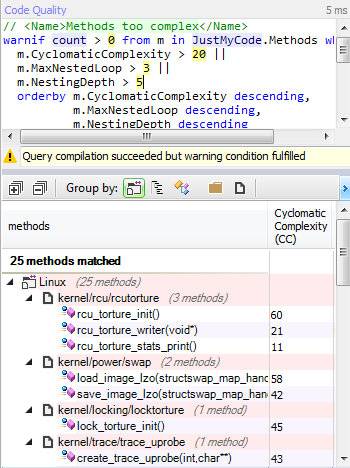
只有极少数函数可以被认为是复杂的。
命名约定
命名约定没有通用标准;每个项目都可以选择最适合自己的方式。然而,始终如一地遵循所选约定非常重要。
例如,在 Linux 的案例中,结构体必须以小写字母开头,我们可以检查整个内核源代码是否确实如此。让我们执行下面的查询:
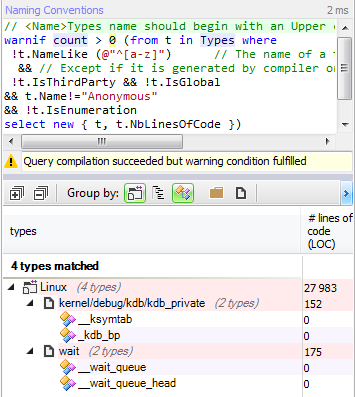
只有 4 个结构体以"_"开头,而不是小写字母。
缩进
缩进对于让代码易于阅读非常有用。以下是Linux 编码风格网页上关于缩进背后动机的说明:
Rationale: The whole idea behind indentation is to clearly define where
a block of control starts and ends.  Especially when you've been looking
at your screen for 20 straight hours, you'll find it a lot easier to see
how the indentation works if you have large indentations.

Now, some people will claim that having 8-character indentations makes
the code move too far to the right, and makes it hard to read on a
80-character terminal screen.  The answer to that is that if you need
more than 3 levels of indentation, you're screwed anyway, and should fix
your program.
结论
研究知名的开源项目始终是提升编程技能的好方法。无需下载和构建项目——比如,您可以直接在 GitHub 上浏览代码。